DataStax
Bundle 包含支持 Langflow 特定第三方集成的自定义组件。
本页描述了 DataStax bundle 中可用的组件。
Astra DB 聊天记忆
Astra DB 聊天记忆组件使用 Astra DB 数据库检索和存储聊天消息。
聊天记忆在记忆存储组件之间作为 Memory 数据类型传递。
具体来说,该组件创建 AstraDBChatMessageHistory 的实例,这是一个使用 Astra DB 进行存储的 LangChain 聊天消息历史类。
Astra DB 聊天记忆组件不推荐用于大多数记忆存储,因为记忆通常是长 JSON 对象或字符串,经常超过 Astra DB 支持的文档或对象的最大大小。
但是,Langflow 的 智能体和 语言模型组件包含默认启用的内置聊天记忆。 您的流程不需要外部数据库来存储聊天记忆。
有关在流程中使用外部聊天记忆的更多信息,请参阅 消息历史组件。
Astra DB 聊天记忆参数
某些组件输入参数在可视化编辑器中默认隐藏。 您可以通过组件标题菜单中的 控制切换参数。
| 名称 | 类型 | 描述 |
|---|---|---|
| collection_name | String | 输入参数。用于存储消息的 Astra DB 集合名称。必需。 |
| token | SecretString | 输入参数。用于 Astra DB 访问的身份验证令牌。必需。 |
| api_endpoint | SecretString | 输入参数。Astra DB 服务的 API 端点 URL。必需。 |
| namespace | String | 输入参数。集合在 Astra DB 中的可选命名空间。 |
| session_id | MessageText | 输入参数。聊天会话的唯一标识符。如果未提供,则使用当前会话 ID。 |
Astra DB CQL
Astra DB CQL 组件允许智能体从 Astra DB 中的 CQL 表查询数据。
输出是包含来自 Astra DB CQL 表的查询结果的 Data 对象列表。每个 Data 对象包含由投影字段指定的文档字段。受 number_of_results 参数限制。
Astra DB CQL 参数
某些组件输入参数在可视化编辑器中默认隐藏。 您可以通过组件标题菜单中的 控制切换参数。
| 名称 | 类型 | 描述 |
|---|---|---|
| Tool Name | String | 输入参数。在智能体提示中引用工具使用的名称。 |
| Tool Description | String | 输入参数。工具的简要描述,用于指导模型使用它。 |
| Keyspace | String | 输入参数。键空间的名称。 |
| Table Name | String | 输入参数。要查询的 Astra DB CQL 表的名称。 |
| Token | SecretString | 输入参数。用于 Astra DB 的身份验证令牌。 |
| API Endpoint | String | 输入参数。Astra DB API 端点。 |
| Projection Fields | String | 输入参数。要返回的属性,用逗号分隔。默认:*。 |
| Partition Keys | Dict | 输入参数。模型必须填写以查询工具的必需参数。 |
| Clustering Keys | Dict | 输入参数。模型可以填写以优化查询的可选参数。必需参数应标记感叹号,例如 !customer_id。 |
| Static Filters | Dict | 输入参数。用于过滤查询结果的属性-值对。 |
| Limit | String | 输入参数。要返回的记录数。 |
Astra DB 工具
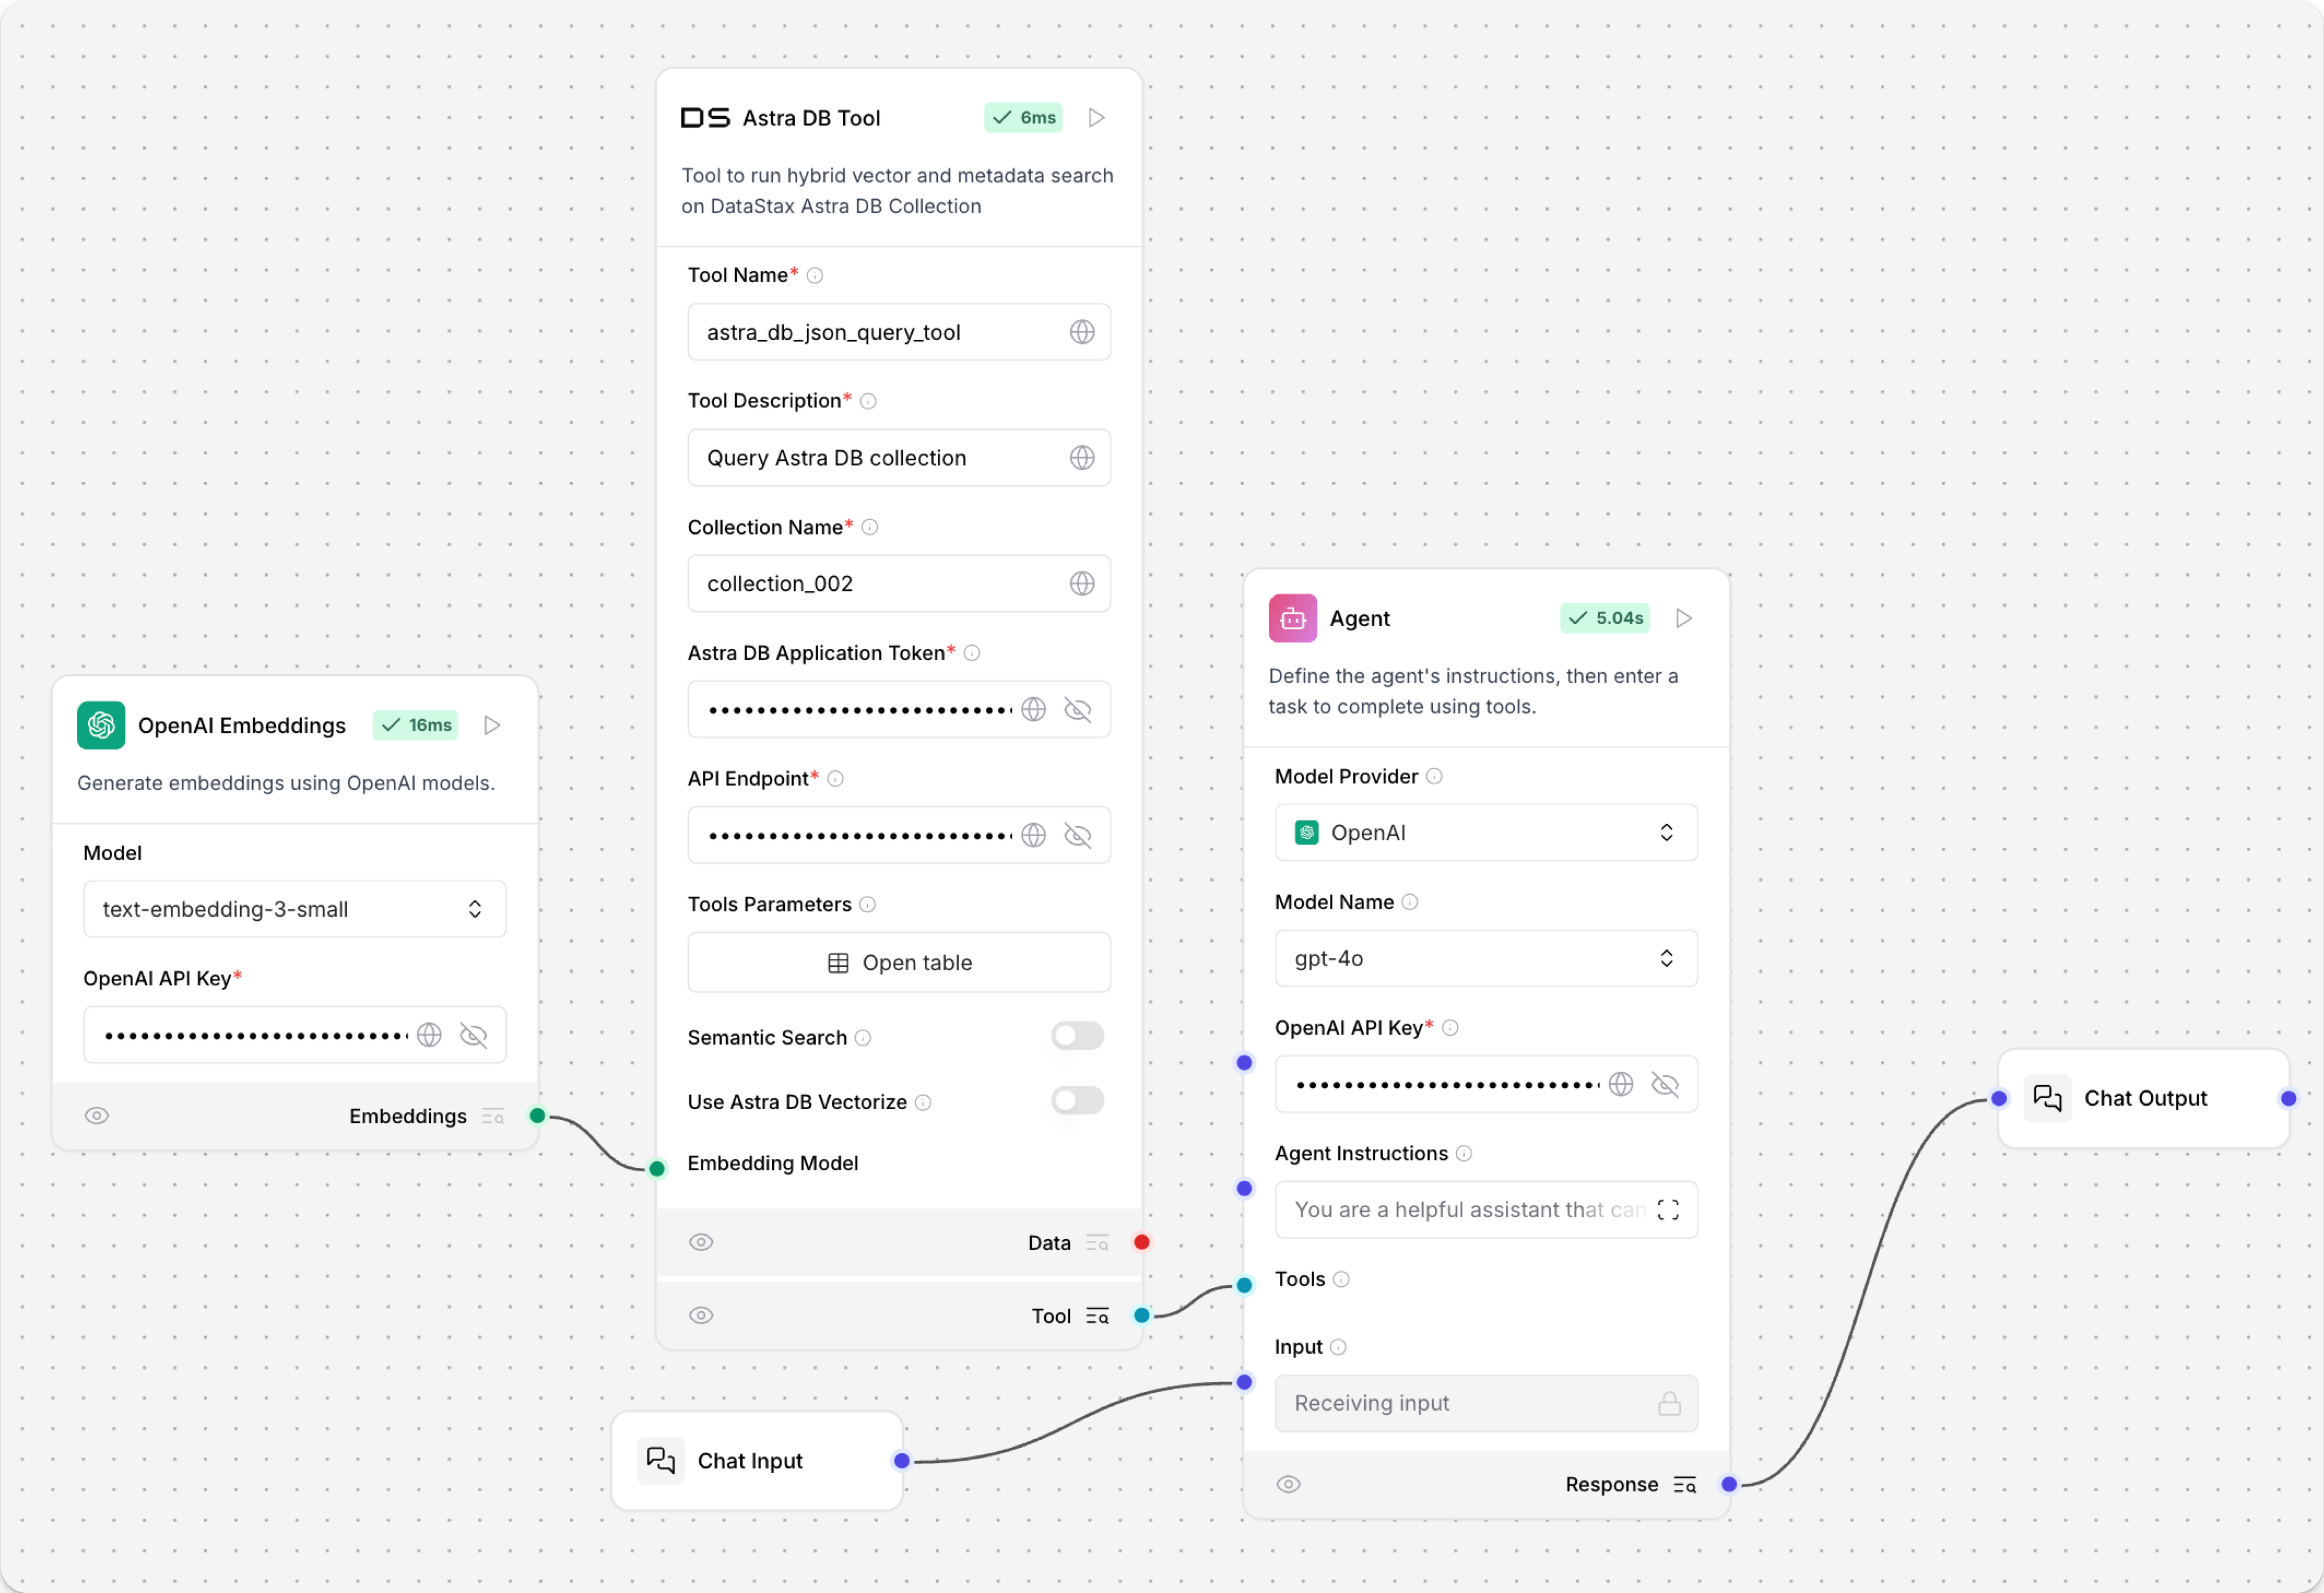
Astra DB 工具组件支持在 Astra DB 集合中搜索数据,包括混合搜索、向量搜索和常规基于过滤器的搜索。 专门化搜索需要集合预配置所需参数。
输出包含来自 Astra DB 的查询结果的 Data 对象列表。每个 Data 对象包含由投影属性指定的文档字段。受 number_of_results 参数和 Astra DB Data API 上限限制,具体取决于搜索类型。
您可以使用该组件在流程中作为独立步骤直接执行查询,或者可以将其作为智能体的工具连接,以允许智能体根据需要从 Astra DB 集合查询数据以响应用户查询。 有关更多信息,请参阅使用 Langflow 智能体。
Astra DB 工具参数
以下参数适用于整个 Astra DB 工具组件。
集合名称、Astra DB 应用程序令牌和 Astra DB API 端点的值可在您的 Astra DB 部署中找到。有关更多信息,请参阅 Astra DB Serverless 文档。
| 名称 | 类型 | 描述 |
|---|---|---|
| Tool Name | String | 输入参数。在智能体提示中引用工具使用的名称。 |
| Tool Description | String | 输入参数。工具的简要描述。这有助于模型决定何时使用它。 |
| Keyspace Name | String | 输入参数。Astra DB 中键空间的名称。默认:default_keyspace |
| Collection Name | String | 输入参数。要查询的 Astra DB 集合的名称。 |
| Token | SecretString | 输入参数。用于访问 Astra DB 的身份验证令牌。 |
| API Endpoint | String | 输入参数。Astra DB API 端点。 |
| Projection Fields | String | 输入参数。要从匹配文档返回的属性的逗号分隔列表。默认是默认投影 *,返回除 $vector 等保留字段之外的所有属性。 |
| Tool Parameters | Dict | 输入参数。成为智能体工具的Astra DB Data API find 过滤器。如果智能体选择这些过滤器,_可能_会在搜索中使用。请参阅定义特定于工具的参数。 |
| Static Filters | Dict | 输入参数。用于过滤查询结果的属性-值对。等同于 Astra DB Data API find 过滤器。静态过滤器包含在_每个_查询中。使用静态过滤器而不进行语义搜索来执行常规过滤器搜索。 |
| Number of Results | Int | 输入参数。要返回的最大文档数。 |
| Semantic Search | Boolean | 输入参数。是否通过从聊天输入生成向量嵌入并遵循语义搜索指令来运行相似性搜索。默认:False。如果为 True,您必须附加嵌入模型组件或在集合上预启用向量化。 |
| Use Astra DB Vectorize | Boolean | 输入参数。在运行语义搜索时是否使用 Astra DB 向量化功能进行嵌入生成。默认:False。如果为 True,您必须在集合上预启用向量化。 |
| Embedding Model | Embedding | 输入参数。附加嵌入模型组件的端口,用于从输入文本生成语义搜索向量。当语义搜索为 True 时,可与或不与向量化一起使用。确保使用与集合中已存在的嵌入维度对齐的模型。 |
| Semantic Search Instruction | String | 输入参数。用于相似性搜索的查询。默认:"Find documents similar to the query."。此指令用于指导模型执行语义搜索。 |
定义特定于工具的参数
工具参数是您在 Astra DB 工具组件内创建的小函数。 它们为 LLM 提供与集合中数据交互的预定义方式。
没有这些过滤器,LLM 不了解集合中的数据或哪些属性重要。
在运行时,LLM 可以决定哪些过滤器与当前查询相关。
工具参数中的过滤器并不总是应用。 如果您想对_每个_查询强制执行过滤器,请使用静态过滤器参数。 您可以同时使用工具参数和静态过滤器来设置一些必需过滤器和一些可选过滤器。
在 Astra DB 工具组件的工具参数字段中,您可以创建过滤器来查询集合中的文档。
在与智能体一起使用的工具模式中,这些过滤器告诉智能体哪些文档属性最重要、搜索中需要哪些属性以及在某些属性上使用哪些操作符。 过滤器成为 LLM 在调用工具时可以使用的参数,描述字段提供了对每个参数更好的理解。
在工具参数窗格中,点击 添加新行,然后编辑行中的每个单元格。
例如,以下过滤器允许 LLM 按唯一的 customer_id 值过滤:
- 名称:
customer_id - 属性名称:如果属性与数据库中的字段名称匹配,请留空。
- 描述:
"用于过滤的客户的唯一标识符"。 - 是元数据:除非值存储在元数据字段中,否则为
False。 - 是必需的:
True要求此过滤器。 - 是时间戳:对于此示例,选择
False,因为值是 ID,不是时间戳。 - 操作符:
$eq查找完全匹配。
工具参数窗格中每行可用的字段如下:
| 参数 | 描述 |
|---|---|
| 名称 | 向 LLM 公开的参数名称。它可以与底层字段名称相同,也可以是更具描述性的标签。LLM 使用此名称以及描述来推断在执行期间提供什么值。 |
| 属性名称 | 当向 LLM 显示的参数名称与数据库中的实际字段或属性不同时,使用此设置将面向用户的名称映射到正确的属性。例如,要对时间戳字段应用范围过滤器,定义两个单独的参数,如 start_date 和 end_date,它们都引用同一个时间戳属性。 |
| 描述 | 向 LLM 提供如何使用参数的指令。清晰具体的指导有助于 LLM 提供有效输入。例如,如果像 specialty 这样的字段以小写存储,描述应说明输入必须是小写。 |
| 是元数据 | 当使用 LangChain 或 Langflow 加载数据时,其他属性可能存储在元数据对象下。如果目标属性以这种方式存储,启用此选项。它通过生成格式为 {"metadata.<attribute_name>": "<value>"} 的过滤器来调整查询 |
| 是时间戳 | 对于基于日期或时间的过滤器,启用此选项以自动将值转换为 Astrapy 客户端期望的时间戳格式。这确保与底层 API 的兼容性,无需手动格式化。 |
| 操作符 | 定义应用于属性的过滤逻辑。您可以使用任何有效的 Data API 过滤器操作符。例如,要在时间戳属性上过滤时间范围,使用两个参数:一个使用 $gt 操作符表示"大于",另一个使用 $lt 操作符表示"小于"。 |
Cassandra 聊天记忆
Cassandra 聊天记忆组件使用基于 Apache Cassandra 的数据库(包括 Astra DB 和超融合数据库 (HCD))检索和存储聊天消息。
聊天记忆在记忆存储组件之间作为 Memory 数据类型传递。
具体来说,该组件创建 CassandraChatMessageHistory 的实例,这是一个使用 Cassandra 数据库进行存储的 LangChain 聊天消息历史类。
有关在流程中使用外部聊天记忆的更多信息,请参阅 消息历史组件。
Cassandra 聊天记忆参数
某些组件输入参数在可视化编辑器中默认隐藏。 您可以通过组件标题菜单中的 控制切换参数。
| 名称 | 类型 | 描述 |
|---|---|---|
| database_ref | MessageText | 输入参数。Cassandra 数据库的联系点或 Astra DB 数据库 ID。必需。 |
| username | MessageText | 输入参数。Cassandra 的用户名。对于 Astra DB 留空。 |
| token | SecretString | 输入参数。Cassandra 的密码或 Astra DB 的令牌。必需。 |
| keyspace | MessageText | 输入参数。Cassandra 中的键空间或 Astra DB 中的命名空间。必需。 |
| table_name | MessageText | 输入参数。用于存储消息的表或集合的名称。必需。 |
| session_id | MessageText | 输入参数。聊天会话的唯一标识符。可选。 |
| cluster_kwargs | Dictionary | 输入参数。Cassandra 集群配置的其他关键字参数。可选。 |
DataStax 助手组件
以下 DataStax 组件用于在流程中创建和管理助手 API 功能:
- Astra Assistant Agent
- Create Assistant
- Create Assistant Thread
- Get Assistant Name
- List Assistants
- Run Assistant
DataStax 环境变量组件
以下 DataStax 组件用于在流程中加载和检索环境变量:
- Dotenv
- Get Environment Variable
传统 DataStax 组件
以下组件被认为是传统的或已弃用的。 这些组件不再开发,可能在未来版本中删除。
尽快用建议的替代方案替换它们。
Astra DB Vectorize
此组件在 Langflow 版本 1.1.2 中已弃用。 尽快用 Astra DB 向量存储组件 替换它。
Astra DB Vectorize 组件用于与 Astra DB 向量存储组件一起使用 Astra DB 的向量化功能生成嵌入。
向量化功能现在内置于 Astra DB 向量存储组件中。 您不再需要单独的组件来进行向量化嵌入生成。